Core Values
AI의 가치는 도입이 아니라 운영에서 완성됩니다.
치타는 GPU 자원, MLOps 및 LLMOps 워크로드, 모델, AI 서비스를 하나의 운영 흐름으로 연결합니다.


하나의 AI 운영 흐름
GPU 자원 관리부터 AI 작업 실행,
모델 평가·배포, 추론 서비스 운영까지
하나의 흐름으로 연결하여 일관되게 관리합니다.

정책 기반 자동화와 운영자 판단
반복 가능한 운영은 정책에 따라 자동화하고,
승인·예외 처리·운영 결정은 사람이 통제하여
자동화와 운영자 판단을 균형 있게 적용합니다.

운영 데이터의 지속적인 활용
운영 과정에서 축적된 데이터와
품질 정보를 분석·활용하여 AI 서비스의
지속적인 개선과 운영 최적화를 지원합니다.
Features
GPUOps · MLOps · LLMOps 통합 플랫폼, 치타
효율적인 GPU 자원 운영
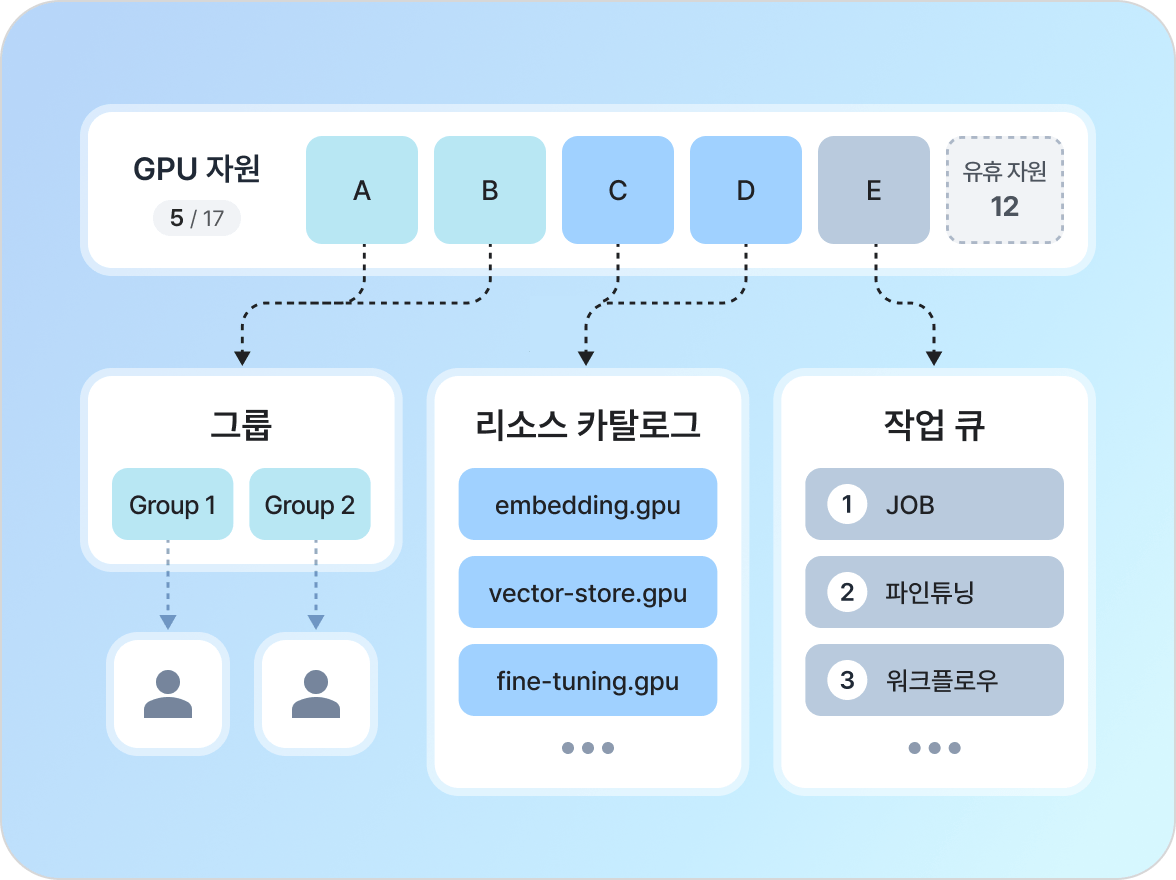
한정된 GPU 자원을
정책과 우선순위에 따라 운영
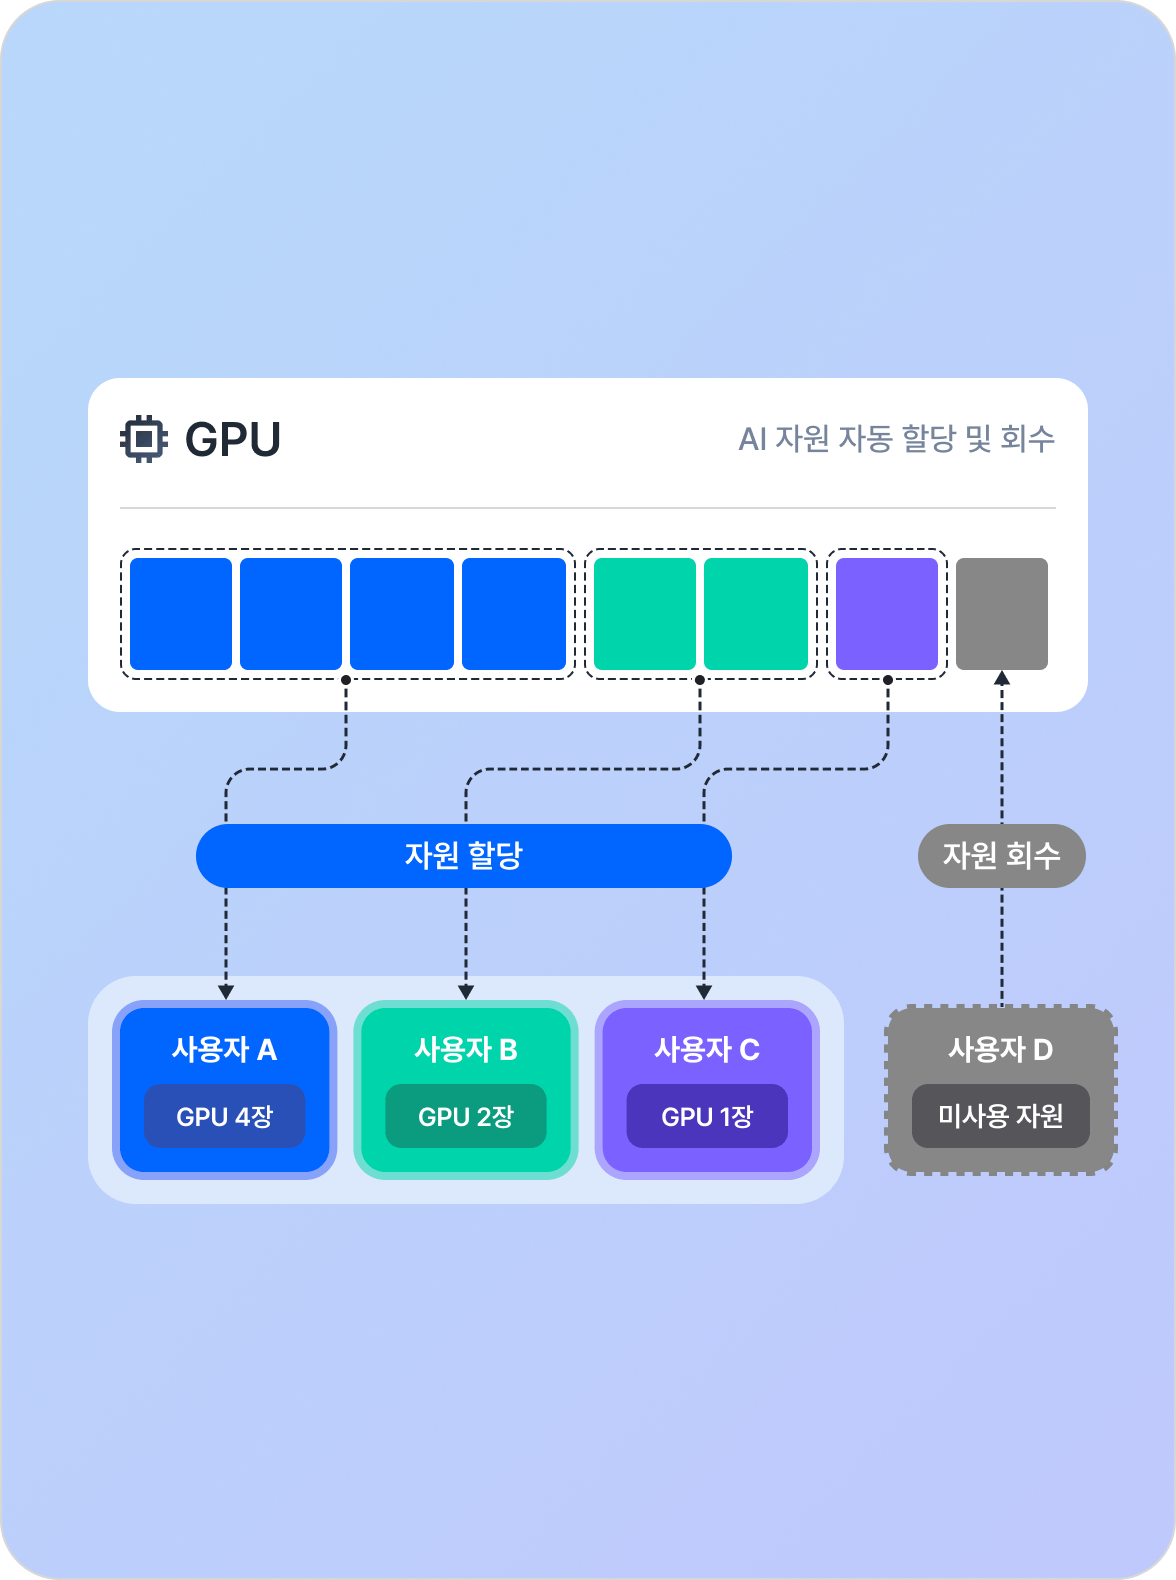
다양한 자원 운영 정책으로 한정된 GPU 활용도를 극대화하고,
사용자·그룹별 자동 할당·회수로 유휴 자원을 줄이고 필요한 곳에 즉시 배분합니다.
리소스 카탈로그 기반으로 워크로드에 적정 자원을 체계적으로 제공합니다.
또한 우선순위에 따라 작업 실행 순서를 조정해 GPU 효율적으로 공유합니다.
모델 개발은 빠르게, 운영은 안정적으로
AI 전 과정을 보다 신속하게,
효율적으로 관리하는 MLOps 체계
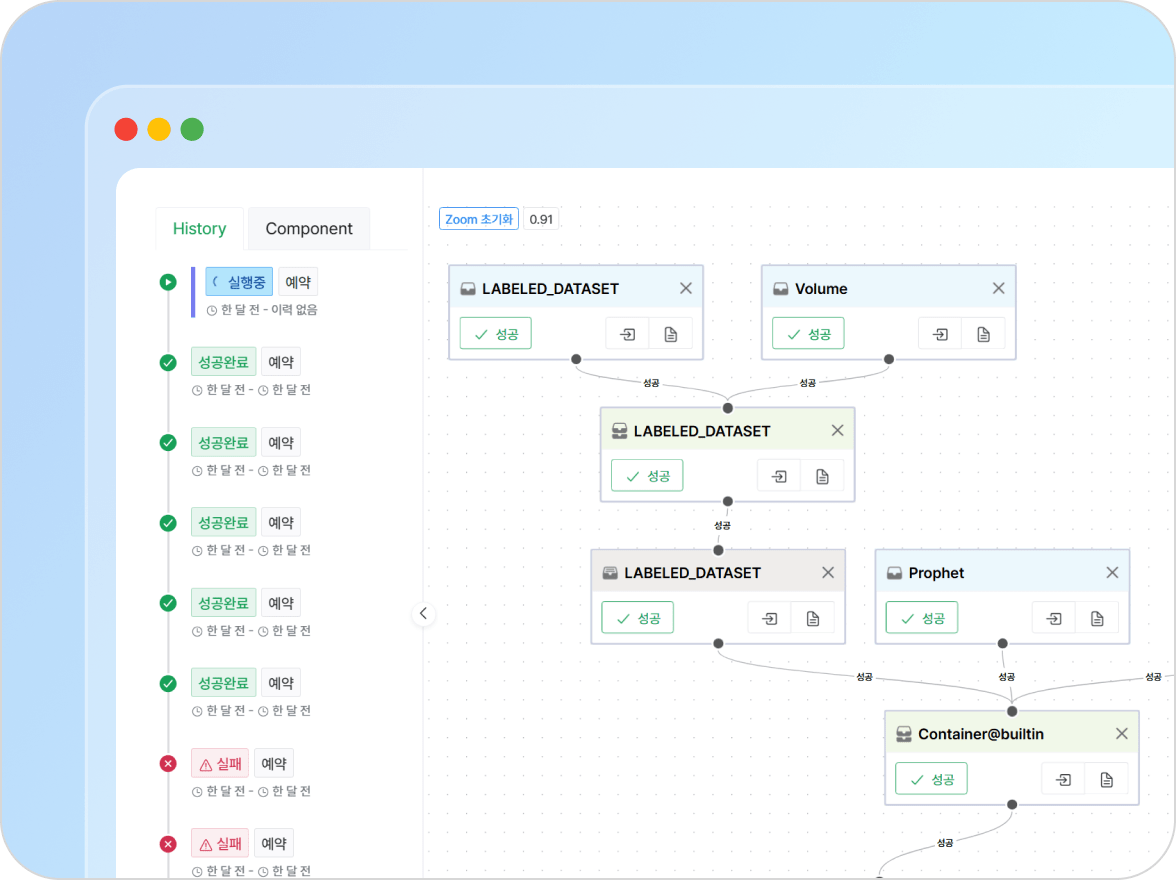
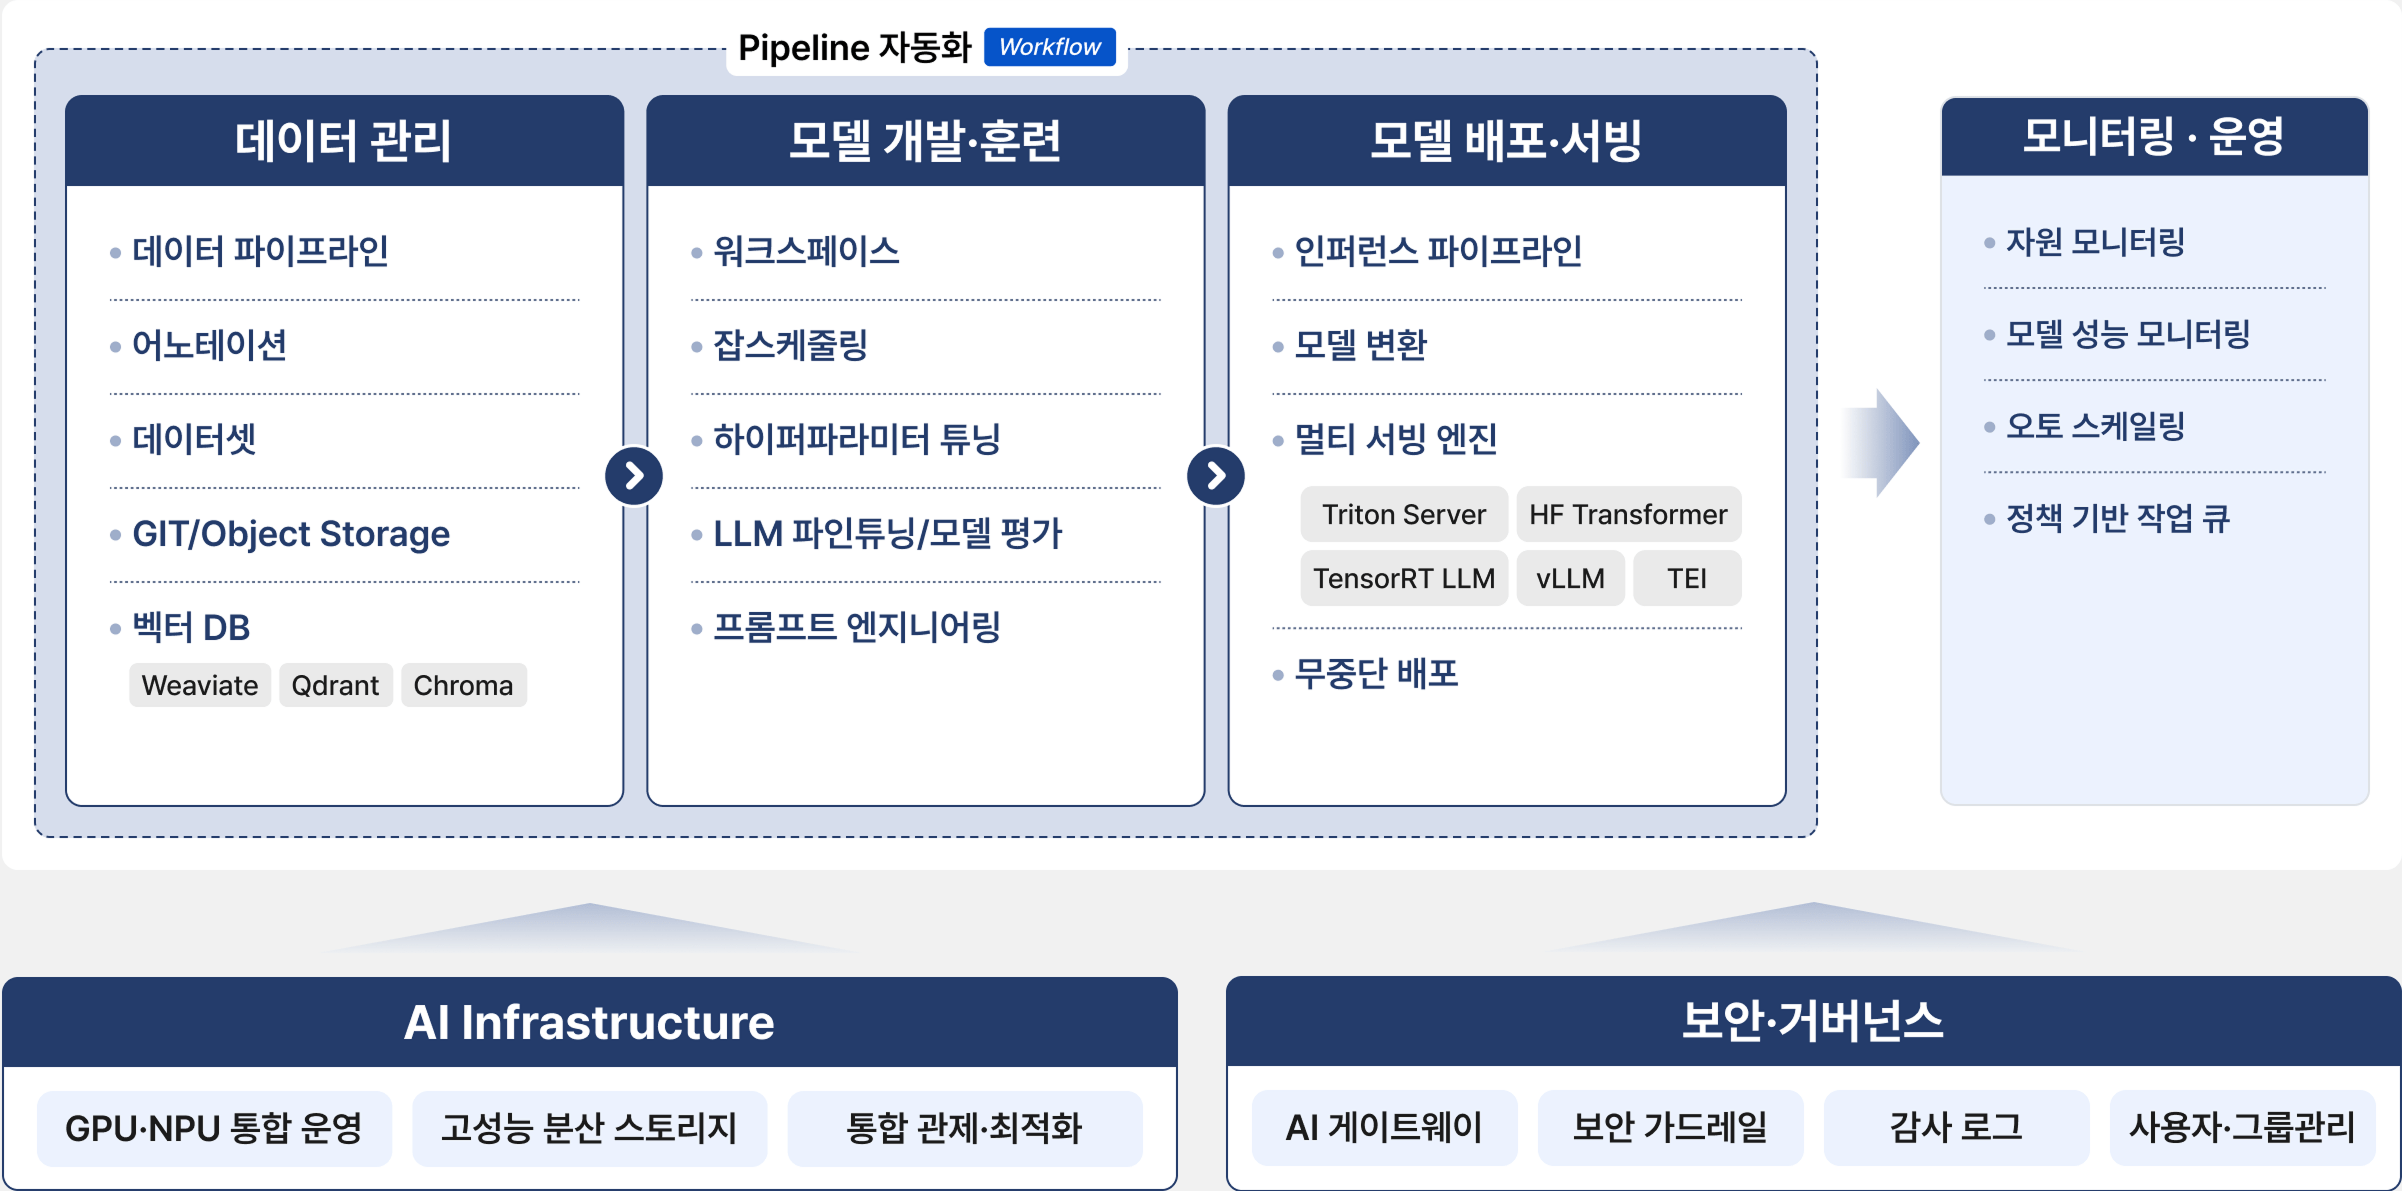
데이터 수집부터 모델 운영까지 AI 라이프사이클을 통합 관리합니다.
검증된 표준 개발환경을 1분 내 구성해 빠르게 모델 개발을 시작하고,
데이터 전처리와 모델 학습·배포 등 반복 작업을 자동화합니다.
학습된 AI 모델은 클릭만으로 배포하고, 안정적으로 운영합니다.
유연하고 안정적인 모델·서비스 운영
온프레미스 환경에서 구현하는
안정적인 LLMOps
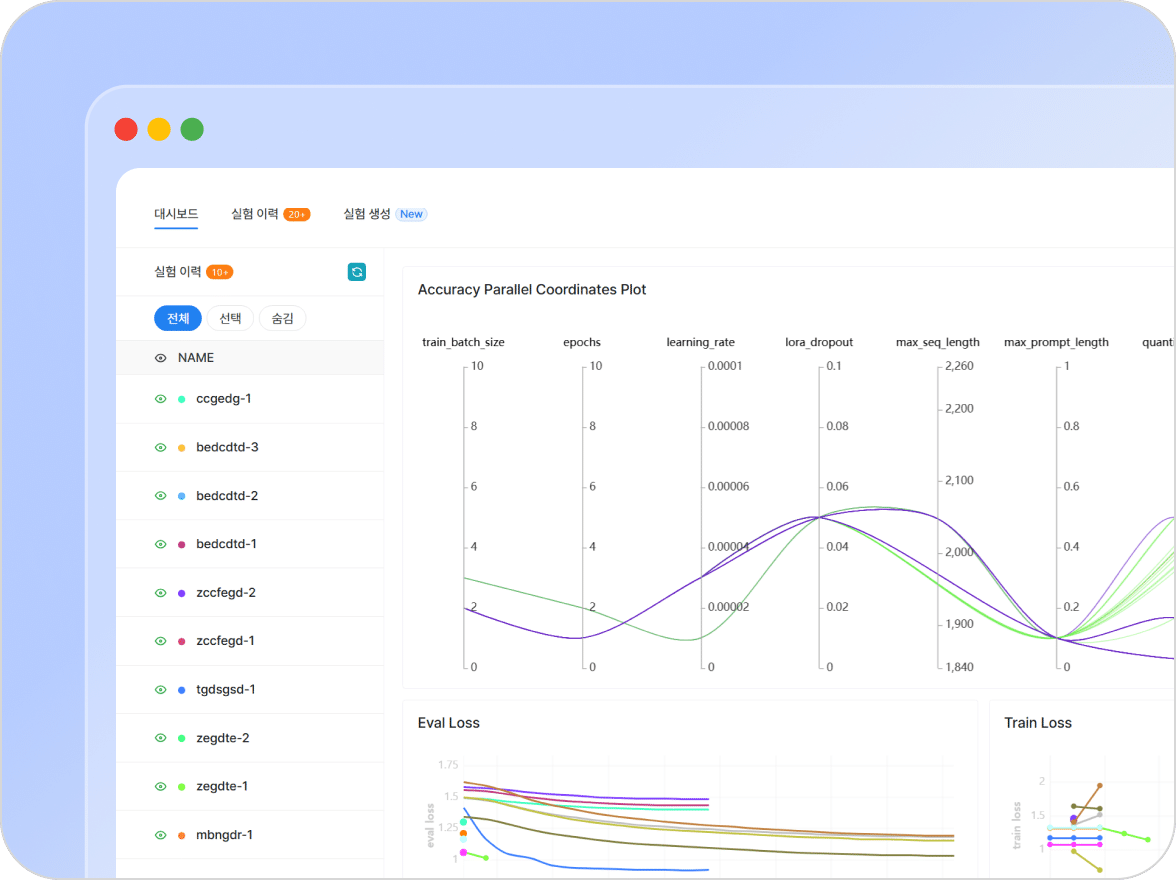
폐쇄망 환경에서도 GUI 기반으로 손쉽게 LLM을 최적화합니다.
한국어 벤치마크와 리더보드로 모델별 성능을 비교하고 검증합니다.
검증된 모델은 다양한 서빙 엔진으로 배포하고, 중단 없이 전환합니다.
모델 운영 상태를 모니터링하고, 부하 변화에 유연하게 대응합니다.
정책 기반의 AI 운영 통제
기업 보안과 AI 운영 정책을
하나의 Gateway로 통합 관리
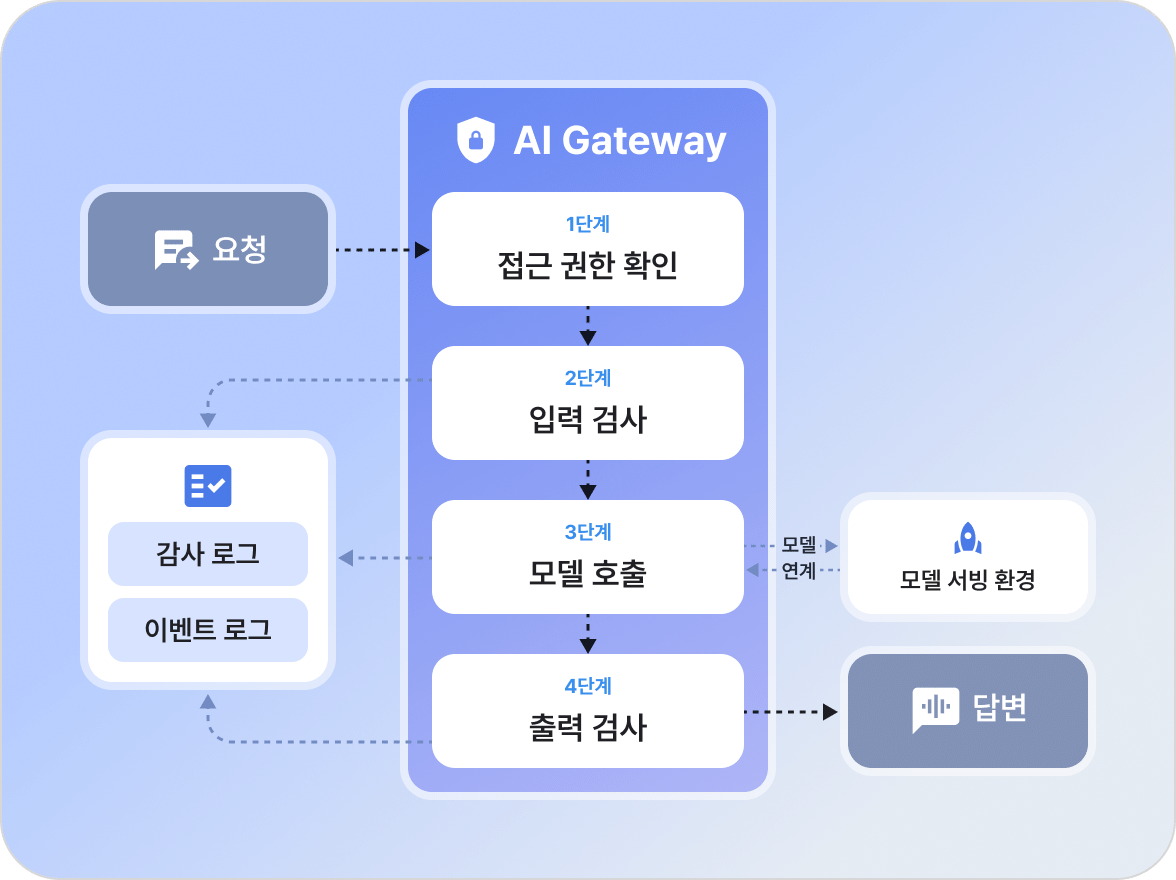
AI 서비스의 모든 요청·응답을 하나의 Gateway에서 일관되게 관리합니다.
접근·호출량을 제어하고, 가드레일로 개인정보·유해 콘텐츠를 차단합니다.
Rate Limit과 Circuit Breaker로 과도한 요청과 장애 확산을 방지하며,
요청별 처리 결과와 감사 이력을 추적해 운영 현황을 통제합니다.
가시화된 통합 운영 체계
AI 자원과 시스템, 사용자에 대한
체계적인 통합 운영 관리
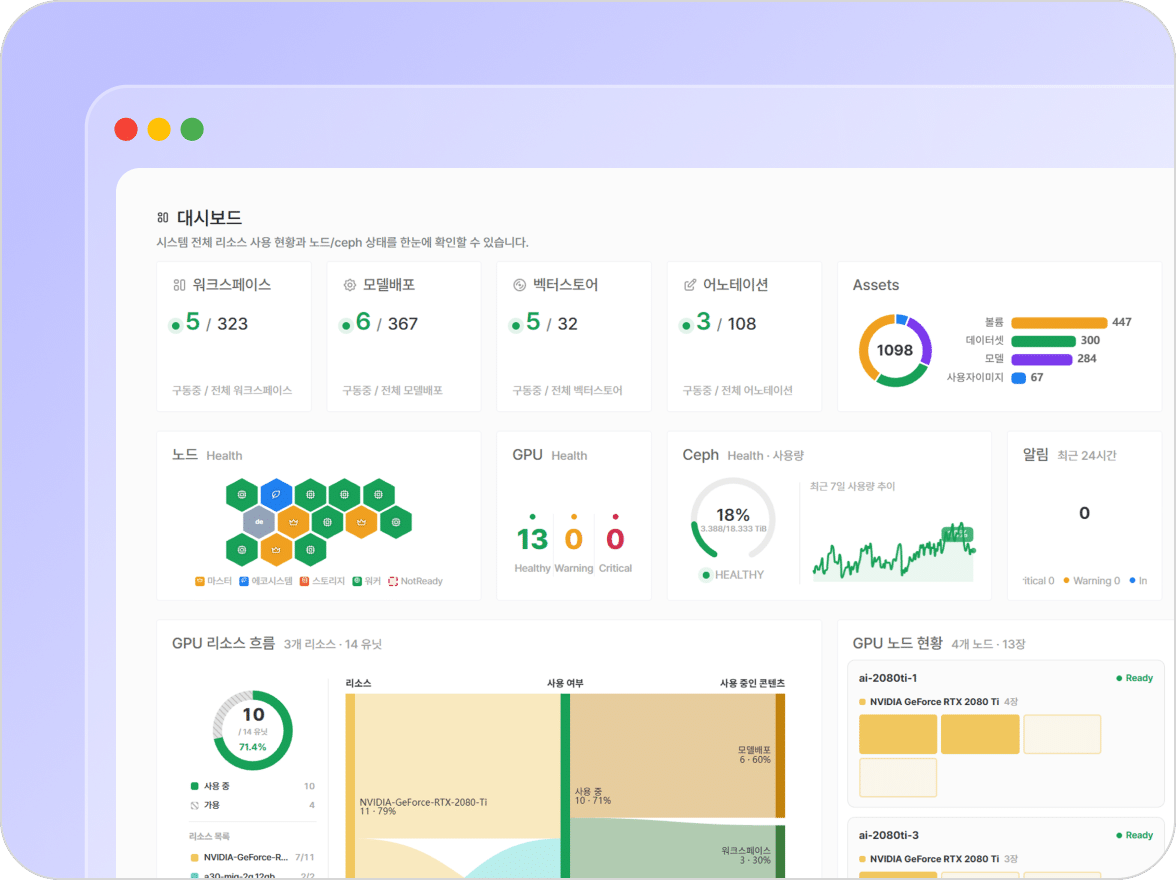
대시보드로 GPU·CPU 상태와 사용률을 실시간 확인합니다.
그룹별 권한·자원 관리로 자산을 보호하고 운영을 체계화합니다.
요청·승인 기반 자원 할당으로 무분별한 사용을 통제합니다.
운영 전반을 투명하게 추적해 안전성과 관리 책임을 함께 확보합니다.
Strengths
특장점
Architecture
CHEETAH Workflow
더 다양한 고객사례를 확인해보세요.
셀트리온은 외부 AI 모델 활용이 제한된 환경에서 내부 연구 및 업무 AX를 추진하기 위해 치타를 AI 플랫폼으로 선정하였으며, 단계적인 GPU 증설 및 전사 AI 개발·운영을 위한 환경을 구축하였습니다.
울산테크노파크는 지역 제조기업의 AI 개발·실증을 지원하기 위해 치타 기반의 공용 AI 플랫폼을 구축하였으며, GPU 자원을 입주기업에 효율적으로 할당하고 AI 개발부터 실증까지 지원할 수 있는 환경을 마련하였습니다.
DB손해보험은 전사 AI OCR 개발·운영 환경 마련을 위해 AI-OCR 플랫폼 구축을 추진하였습니다. 이를 통해 보험 서류 처리 업무의 정확도와 운영 효율성을 높이고, AI OCR 모델을 안정적으로 관리할 수 있는 기반을 마련하였습니다.