Core Values
AI의 가치는 도입이 아니라 운영에서 완성됩니다.
치타는 GPU 자원, AI 워크로드, 모델 서비스를 하나의 정책과 운영 흐름으로 연결합니다.


하나의 AI 운영 흐름
GPU 자원 관리부터 AI 작업 실행,
모델 평가·배포, 추론 서비스 운영까지
하나의 흐름으로 연결하여 일관되게 관리합니다.

정책 기반 자동화와 운영자 판단
반복 가능한 운영은 정책에 따라 자동화하고,
승인·예외 처리·운영 결정은 사람이 통제하여
자동화와 운영자 판단을 균형 있게 적용합니다.

운영 데이터의 지속적인 활용
운영 과정에서 축적된 데이터와
품질 정보를 분석·활용하여 AI 서비스의
지속적인 개선과 운영 최적화를 지원합니다.
Features
변화하는 AI를, 통제 가능한 운영으로
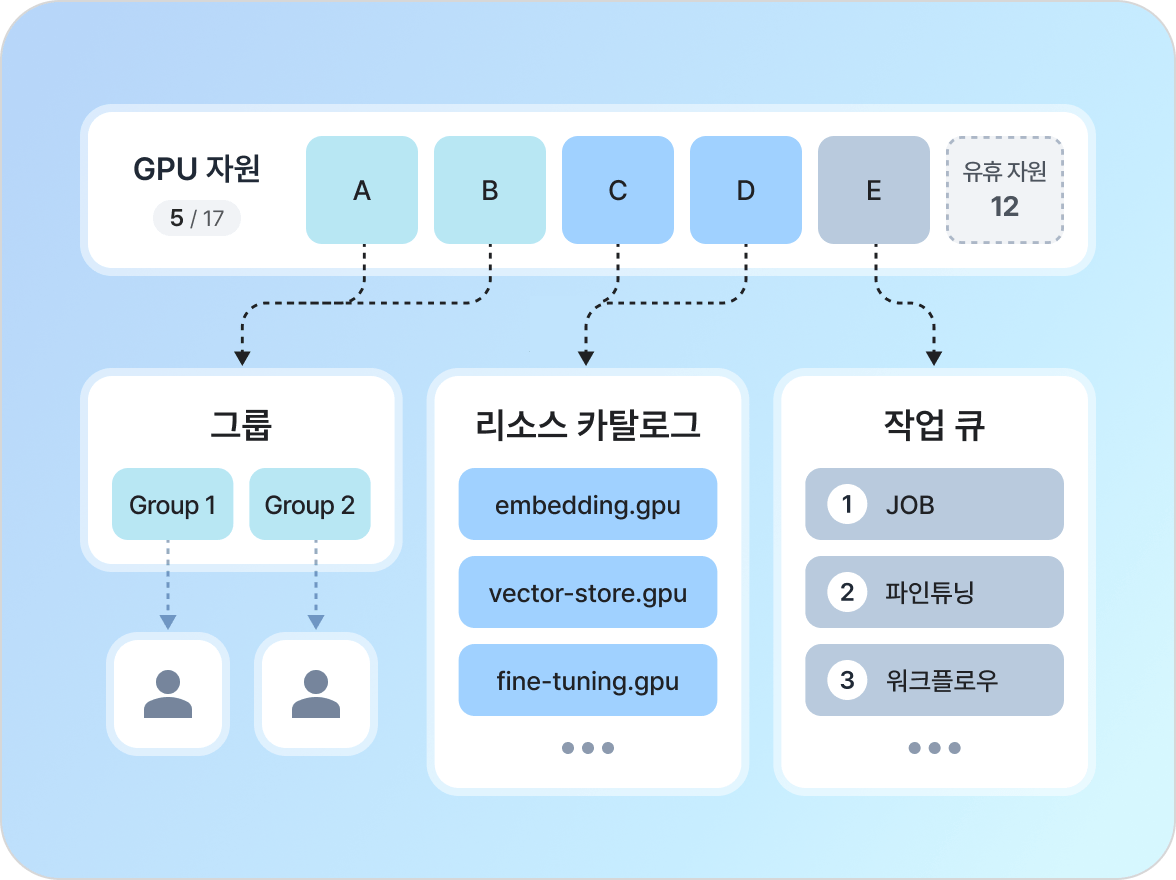
효율적인 GPU 자원 운영
한정된 GPU 자원을
정책과 우선순위에 따라 운영
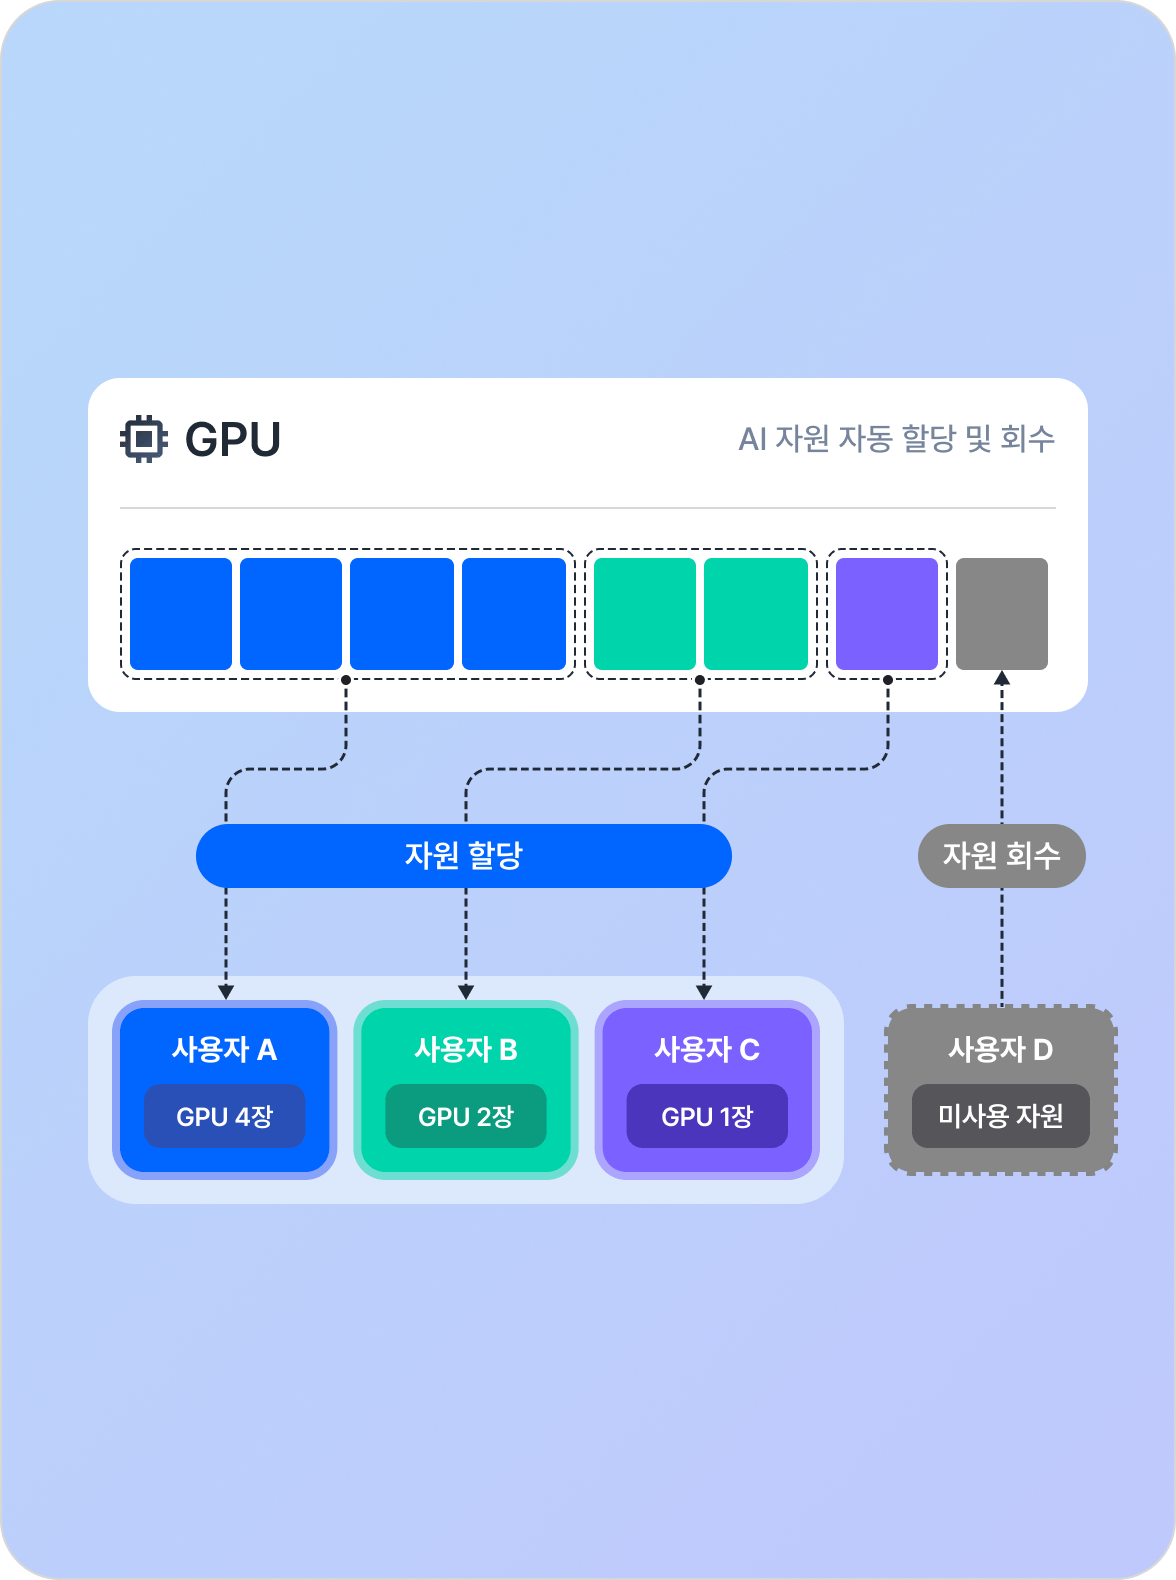
다양한 자원 운영 정책으로 한정된 GPU 활용도를 극대화하고,
사용자·그룹별 자동 할당·회수로 유휴 자원을 줄이고 필요한 곳에 즉시 배분합니다.
리소스 카탈로그 기반으로 워크로드에 적정 자원을 체계적으로 제공합니다.
또한 우선순위에 따라 작업 실행 순서를 조정해 GPU 효율적으로 공유합니다.
체계적인 AI 워크로드 운영
표준 개발환경과 자동화를 통한
AI 개발·학습 체계화
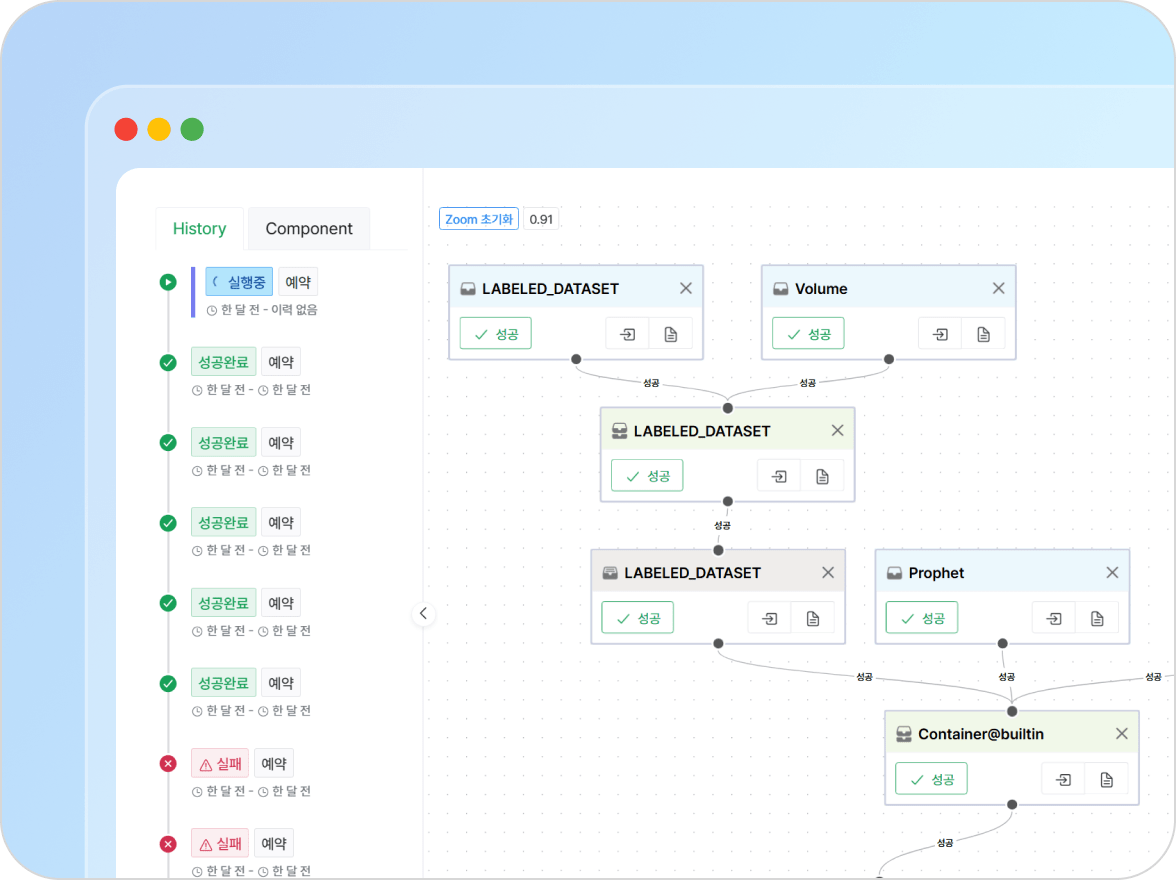
표준화된 개발·학습 환경과 자동화 기능으로 AI 개발 전반의 생산성을 높입니다.
1분 내 검증된 개발환경을 구성해 별도 준비 없이 빠르게 개발을 시작하고,
데이터 수집·전처리부터 모델 학습·배포까지 반복되는 작업을 자동화합니다.
하이퍼파라미터 튜닝으로 최적의 학습 조건을 탐색해 모델 성능 개선까지 지원합니다.
유연하고 안정적인 모델·서비스 운영
검증된 모델을
안정적인 AI 서비스로 운영
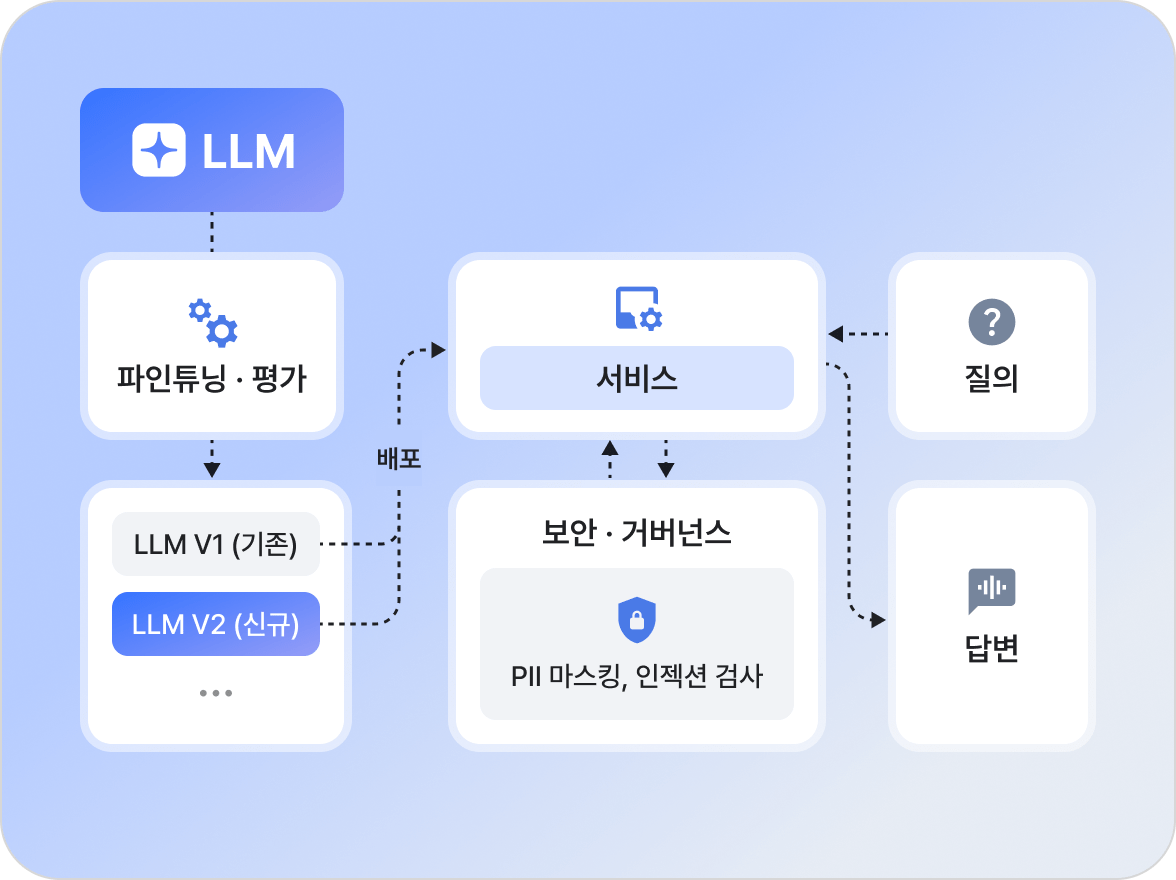
GUI 기반으로 LLM 성능을 손쉽게 개선·평가하고, 모델을 버전별로 관리합니다.
검증된 모델은 기존 서비스 중단 없이 안정적으로 배포·전환합니다.
또한 과도한 호출을 제한하고, 개인정보(PII)와 프롬프트 인젝션을 탐지·차단합니다.
이를 통해 부적절한 입·출력을 통제하고 신뢰도 높은 AI 서비스 품질을 유지합니다.
운영 안정성
가시화된 AI 운영 통제
기업 보안·운영 정책 기반
안전한 AI 서비스 관리·통제
온프레미스·폐쇄망에서도 기존 보안 정책을 유지하며 AI 서비스를 운영합니다.
사용자 역할에 맞는 접근 체계로 주요 자산과 운영환경을 보호하고,
통제된 자원 배분으로 무분별한 사용과 자원 편중을 방지합니다.
운영 전반을 투명하게 추적해 안전성과 관리 책임을 함께 확보합니다.

Strengths
특장점
Architecture
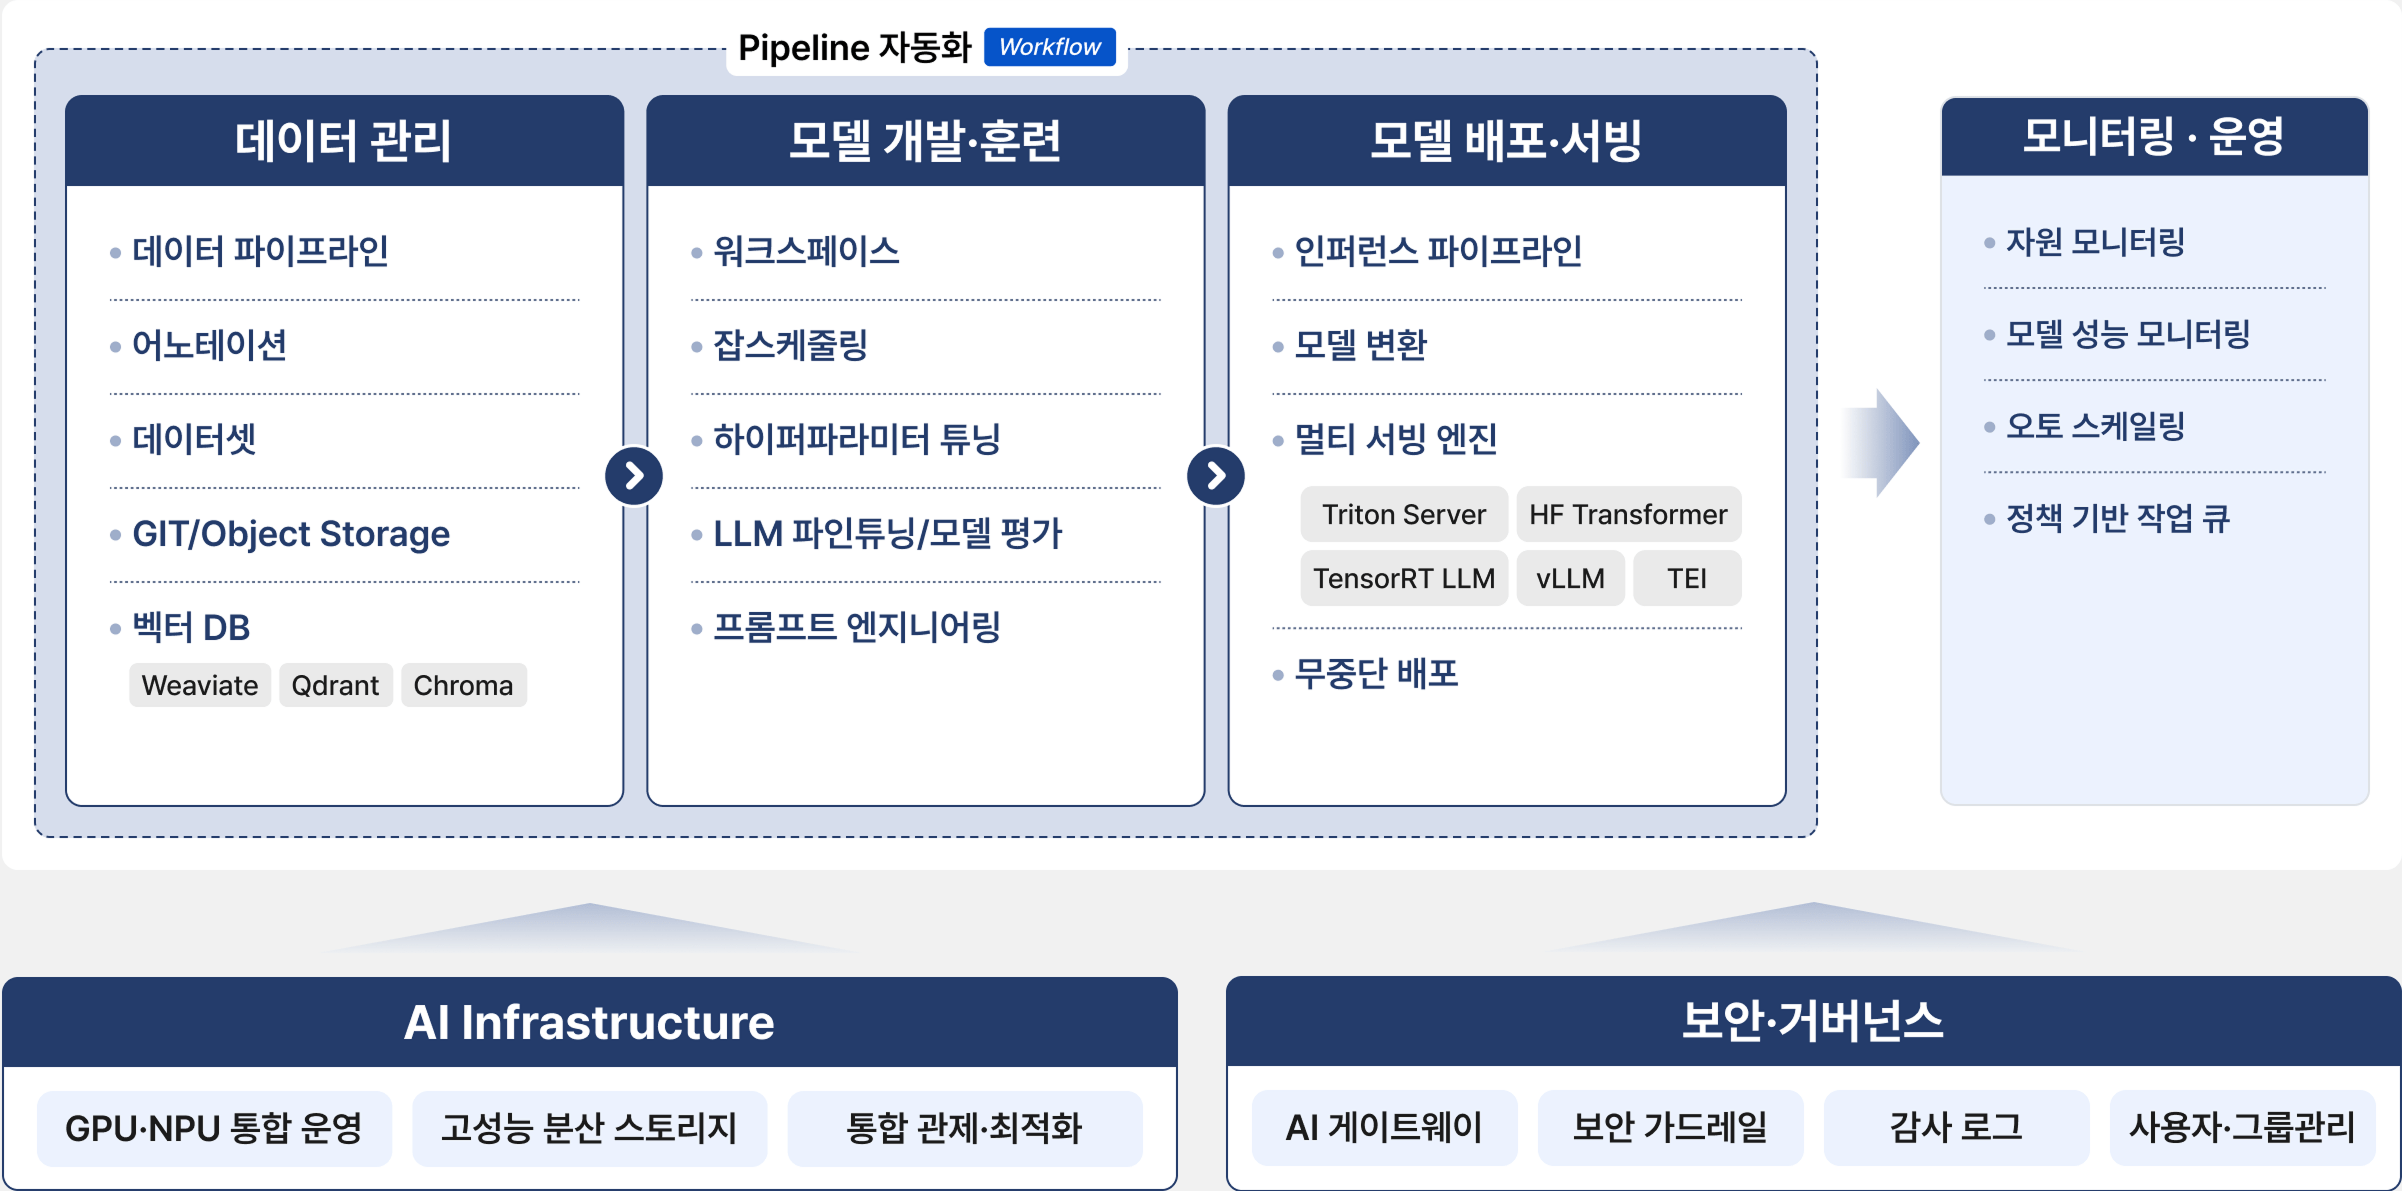
CHEETAH Workflow

더 다양한 고객사례를 확인해보세요.
[한국항공우주산업] AI Pilot 개발·운영을 위한 폐쇄망 MLOps 체계 구축
한국항공우주산업은 차세대 공중전투체계의 AI Pilot 개발을 위해, 폐쇄망 환경에서도 데이터 수집·정제부터 LLM 학습, 배포, 운영까지 전 과정을 체계적으로 관리할 수 있는 MLOps 환경을 구축했습니다. 또한 향후 개발될 다양한 AI 모델의 실증과 활용을 위한 AI Agent 플랫폼 연계 기반도 함께 마련했습니다.
[DBInc] DB그룹 AI 플랫폼 구축
DB Inc.는 DB그룹 내 AI 활용 확대를 위해 LLMOps 기반의 AI 플랫폼 구축을 추진하였습니다. 이를 통해 LLM 개발·검증·배포·운영을 통합 관리하고, AI Agent 서비스까지 확장 가능한 운영 기반을 마련하였습니다.
[신한카드] 데이터 상품 개발을 위한 MLOps 환경 구축
신한카드는 보유 데이터 자산을 활용한 데이터 상품 개발을 위해 MLOps 기반 분석·개발 환경 구축을 추진하였습니다. 이를 통해 데이터셋 관리, 분석 상품 개발, 배포, 리소스 모니터링까지 통합 지원하는 플랫폼 환경을 마련하였습니다.


